بررسی مستند تکامل مدلهای ضریب سازی (Odds Making) از محاسبات دستی تا سامانههای هوشمند و یادگیری ماشین
ضریب (Odds) هسته اصلی بازارهای شرطبندی ورزشی است. هر ضریب در واقع ترجمه عددی یک برآورد احتمالی از وقوع یک رویداد به همراه ملاحظات تجاری، مدیریت ریسک و رفتار بازار است. برخلاف تصور عمومی، ضریب صرفاً «پیشبینی نتیجه مسابقه» نیست؛ بلکه قیمت یک دارایی احتمالاتی است که باید همزمان احتمال واقعی، حاشیه سود بوکمیکر (Overround)، ریسک موجودی سرمایه، نقدشوندگی بازار، جریان سفارشها و رفتار کاربران را منعکس کند.
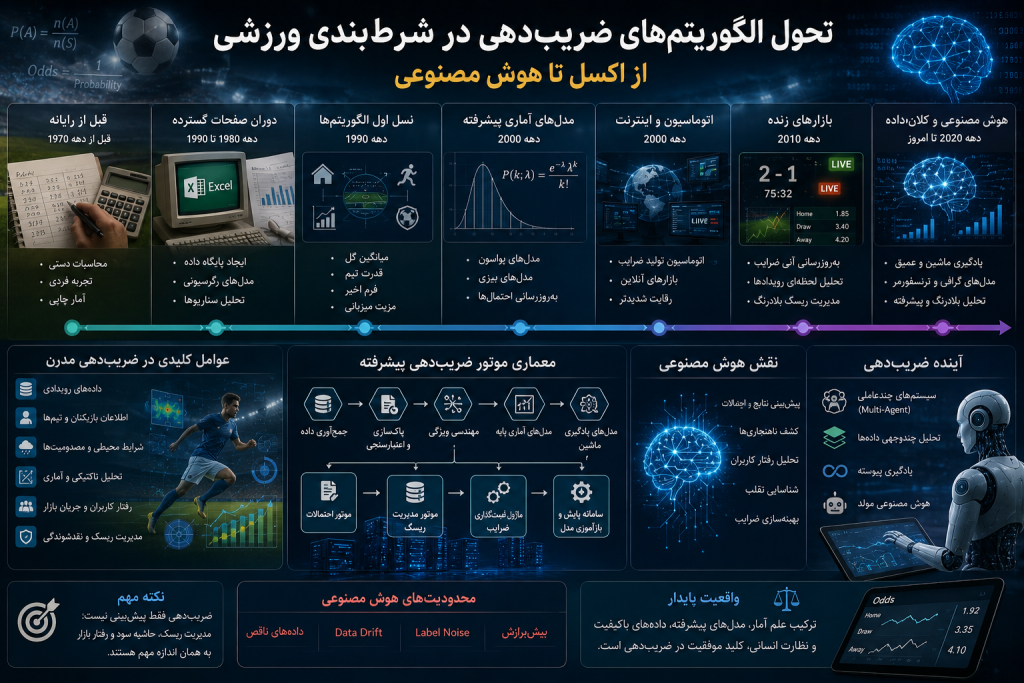
تکامل الگوریتمهای ضریبدهی از دهه ۱۹۷۰ تاکنون، از محاسبات دستی و صفحات گسترده مانند Excel به سامانههای مبتنی بر کلانداده، یادگیری ماشین، یادگیری عمیق، مدلهای بیزی، تحلیل بلادرنگ و هوش مصنوعی رسیده است. با این حال، یک نکته مهم این است که هوش مصنوعی جایگزین نظریه احتمال و مدلهای آماری کلاسیک نشده، بلکه آنها را تکمیل کرده است. در بسیاری از شرکتهای بزرگ، موتور ضریبدهی همچنان ترکیبی از مدلهای آماری، قوانین کسبوکار و الگوریتمهای یادگیری ماشین است.
۱. ضریبدهی چیست؟
در سادهترین تعریف:
ضریبدهی یعنی تبدیل یک احتمال به قیمت بازار.
اگر احتمال برد تیمی ۵۰٪ باشد، ضریب منصفانه (Fair Odds) برابر است با:
Odds = 1 / Probability
بنابراین:
Probability = 0.50
Odds = 2.00
در عمل، بوکمیکر برای پوشش هزینه و سود، حاشیهای به این قیمت اضافه میکند.
۲. دوران قبل از رایانه
تا دهه ۱۹۷۰، بسیاری از ضرایب توسط افراد باتجربه تعیین میشد.
ابزارها:
دفتر
ماشین حساب
آمار چاپی
تجربه شخصی
بود.
۳. ورود صفحات گسترده
در دهه ۱۹۸۰ و ۱۹۹۰، با رواج نرمافزارهای صفحهگسترده مانند Microsoft Excel، بسیاری از تحلیلگران توانستند:
پایگاه داده ایجاد کنند.
مدلهای رگرسیونی اجرا کنند.
محاسبات احتمالاتی را خودکار کنند.
سناریوهای مختلف را مقایسه کنند.
اکسل در این دوره به ابزاری استاندارد برای تحلیل کمی تبدیل شد.
۴. نسل اول الگوریتمها
مدلهای اولیه عمدتاً بر پایه:
میانگین گل
قدرت تیم
مزیت میزبانی
فرم اخیر
اختلاف گل
بودند.
پیچیدگی آنها نسبتاً کم بود.
۵. مدلهای پواسون
از دهه ۱۹۸۰، مدل پواسون به یکی از مهمترین ابزارهای ضریب گذاری فوتبال تبدیل شد.
در این مدل:
گلهای دو تیم بهصورت متغیرهای تصادفی شمارشی مدل میشوند و با ترکیب توزیعها میتوان احتمال نتایج مختلف را برآورد کرد.
۶. ورود مدلهای بیزی
مدلهای بیزی امکان بهروزرسانی احتمالها را با ورود اطلاعات جدید فراهم کردند.
این ویژگی برای شرایطی مانند:
مصدومیت
تغییر ترکیب
شرایط آبوهوا
بسیار ارزشمند است.
۷. اتوماسیون
در اواخر دهه ۱۹۹۰، بسیاری از بوکمیکرها:
تولید ضریب
انتشار بازار
کنترل حاشیه سود
را خودکار کردند.
۸. اینترنت و بازارهای آنلاین
ظهور شرطبندی آنلاین باعث شد:
ضرایب دائماً تغییر کنند.
اطلاعات سریعتر منتشر شوند.
رقابت شدیدتر شود.
در نتیجه، الگوریتمها نیز باید سریعتر عمل میکردند.
۹. بازارهای زنده (In-Play)
با توسعه شرطبندی زنده، الگوریتمها باید در چند ثانیه یا حتی کسری از ثانیه، احتمالها را بهروزرسانی، ضریب ها را بازتنظیم و ریسک را مدیریت میکردند.
۱۰. کلانداده
امروزه مدلها ممکن است هزاران ویژگی را تحلیل کنند، مانند:
دادههای رویدادی
دادههای مکانی
آمار فیزیکی
تاریخچه مسابقات
اطلاعات ترکیب تیم
شرایط محیطی
۱۱. یادگیری ماشین
الگوریتمهایی مانند:
Random Forest
Gradient Boosting
XGBoost
LightGBM
برای کشف روابط غیرخطی میان متغیرها بهکار گرفته شدند.
۱۲. یادگیری عمیق
شبکههای عصبی عمیق میتوانند:
ویدئو
تصاویر
دادههای زمانی
الگوهای پیچیده
را تحلیل کنند.
با این حال، در بسیاری از مسائل ساختاریافته، مدلهای کلاسیک همچنان رقابتپذیر هستند.
۱۳. مدلهای گراف
در سالهای اخیر، Graph Neural Networks (GNN) برای مدلسازی تعامل بازیکنان و ساختار تیمی مورد توجه قرار گرفتهاند.
۱۴. ترنسفورمرها
مدلهای Transformer که ابتدا در پردازش زبان طبیعی توسعه یافتند، اکنون برای تحلیل دنبالههای زمانی، دادههای رویدادی و حتی برخی کاربردهای ورزشی نیز بررسی میشوند.
۱۵. تحلیل بلادرنگ
الگوریتمهای مدرن میتوانند همزمان اطلاعاتی مانند:
گل
اخراج
تعویض
مصدومیت
تغییرات تاکتیکی
را دریافت و احتمالها را بازمحاسبه کنند.
[8/11/2026 1:44 PM] Alfredo: ۱۶. مدیریت ریسک
ضریبدهی صرفاً پیشبینی نیست.
بوکمیکر باید:
حجم شرطها
توازن دو سوی بازار
احتمال زیان
نقدشوندگی
را نیز در نظر بگیرد.
۱۷. الگوریتمهای ضریب گذاری پویا
ضرایب دائماً تغییر میکنند.
دلایل:
ورود اطلاعات جدید
تغییر حجم سفارشها
تغییر ضرایب رقبا
مدیریت موجودی سرمایه
۱۸. نقش هوش مصنوعی
هوش مصنوعی امروزه در بخشهای مختلف استفاده میشود:
پیشبینی
کشف ناهنجاری
تحلیل رفتار کاربران
شناسایی تقلب
بهینهسازی ضریب
اما معمولاً هوش مصنوعی تنها بخشی از موتور ضریبدهی است.
۱۹. نقش انسان
در بسیاری از شرکتها، تحلیلگران حرفهای همچنان خروجی مدلها را بررسی میکنند.
در بازارهای خاص یا شرایط غیرعادی، تصمیم انسانی میتواند نقش مهمی داشته باشد.
۲۰. محدودیتهای هوش مصنوعی
هوش مصنوعی نیز با چالشهایی روبهرو است:
دادههای ناقص
Data Drift
Label Noise
Data Leakage
بیشبرازش (Overfitting)
بنابراین، عملکرد هوش مصنوعی به کیفیت داده و طراحی مدل وابسته است.
۲۱. آینده؛ مدلهای چندعاملی
پژوهشهای جدید به سمت Multi-Agent AI حرکت کردهاند.
در این رویکرد، عاملهای مختلف میتوانند بهطور تخصصی:
تحلیل تاکتیکی
تحلیل آماری
تحلیل مصدومیت
تحلیل بازار
را انجام دهند و نتایج خود را ترکیب کنند.
۲۲. هوش مصنوعی مولد
مدلهای زبانی بزرگ میتوانند:
گزارش مسابقات را خلاصه کنند.
اخبار را تحلیل کنند.
اطلاعات غیرساختاریافته را استخراج کنند.
اما آنها بهتنهایی جایگزین مدلهای احتمالاتی نیستند.
۲۳. معماری مدرن موتور ضریبدهی
یک سامانه پیشرفته امروزی معمولاً از اجزای زیر تشکیل میشود:
جمعآوری داده (Data Ingestion)
پاکسازی و اعتبارسنجی داده
مهندسی ویژگی (Feature Engineering)
مدلهای آماری پایه
مدلهای یادگیری ماشین
موتور احتمالات
موتور مدیریت ریسک
ماژول قیمتگذاری
سامانه پایش و بازآموزی مدل
۲۴. آیا اکسل منسوخ شده است؟
خیر.
با وجود پیشرفتهای عظیم، اکسل هنوز برای:
تحلیل اولیه
اعتبارسنجی
نمونهسازی سریع
گزارشگیری
در بسیاری از تیمهای تحلیل استفاده میشود.
۲۵. مهمترین تحول واقعی
بزرگترین تحول، افزایش قدرت محاسبات نبوده است؛ بلکه ترکیب چهار عامل بوده است:
دادههای بسیار غنیتر،
مدلهای آماری پیشرفتهتر،
زیرساختهای پردازشی قدرتمند،
و بهروزرسانی لحظهای اطلاعات.
تحول الگوریتمهای ضریبدهی از صفحات گسترده و مدلهای آماری ساده تا سامانههای مبتنی بر هوش مصنوعی، نشاندهنده بلوغ تدریجی صنعت تحلیل ورزشی است. با این حال، برخلاف برخی تصورات، هیچ «الگوریتم جادویی» وجود ندارد که بتواند نتایج مسابقات را با قطعیت پیشبینی کند. مدلهای مدرن همچنان بر پایه نظریه احتمال، آمار و مدیریت عدمقطعیت بنا شدهاند و هوش مصنوعی بیشتر نقش تقویتکننده را ایفا میکند تا جایگزین کامل روشهای کلاسیک.
در عمل، موفقترین موتورهای ضریبدهی از ترکیب مدلهای احتمالاتی، یادگیری ماشین، مدیریت ریسک، تحلیل دادههای بلادرنگ و نظارت انسانی استفاده میکنند. آینده این حوزه نیز احتمالاً در جهت سامانههای چندعاملی، تحلیل چندوجهی دادهها و یادگیری پیوسته خواهد بود.